Форум сообщества Zettelkasten работал с 2021 по 2026 год. Читать можно всё, писать — уже нет. Вся жизнь сообщества теперь — в книжном клубе ККРА: встречи, задания, записи и разговоры.
Если в лоб, то что-то вроде того получается. Длинновато, конечно. Наверное, не лучший вариант. Под спойлеры можно засунуть, но вроде в таком случае ссылку не получится добавить на “Content” спойлера.
Ещё как вариант создать первым постом оглавление, а ниже в сообщениях расписать для каждой программы по шаблону Рустама. Для популярных программ, которые обсуждаем, создать отдельные разделы, а краткое описание каждой оставить тут постами.
Я так и понял. Каким образом из ноушн извелкается? Потому что думаю переносить нашу библиотеку, которую насобирали в процессе чтений. Нужно структуру создать.
Супер. Значит с книгами займусь сегодня — завтра. Попробовал сегодня поиграться с датавью, что-то получилось, а что-то нет. Пока не понял по ощущениям, руки еще не привыкли.
Нет. Вместо Atom Microsoft пилит VS Code, в том числе встроит его в веб-интерфейс GitHub. А то что по ссылке: очередные намерения по разработке на расте (модно-молодежно). Когда оно будет, не известно и будет ли вообще. Пять человек обиделись на MS и решили пилить что-то своё)) Удачи им конечно.
У Atom было несколько формальных “родителей”, конкретно эти «родительствее» :0) А Microsoft − формальный родитель, они купили github когда Atom уже более 6 лет «пилили».
Новый редактор сделают, команда сильная. Первые демонстрахи уже начали показывать. Не удивлюсь, кстати, если и сам Microsoft в этот стартап часть денег проинвестировал.
Возможно, имеет смысл дополнить перечень сервисом GitBook, сейчас в нем копаюсь, пока что все нравится, по реализации и функционалу очень напоминает Notion, и возможности бесплатной версии кажутся вполне комфортными для личного использования
Тут уже предложено столько продуктов, что хоть какая-то польза может быть получена при обсуждении аппаратно-независимых Zettelkasten-решений, которые каждый может реализовать на том, что ему удобно, хоть на бумажке, хоть в “специальном форумном ящике”, который необходим.
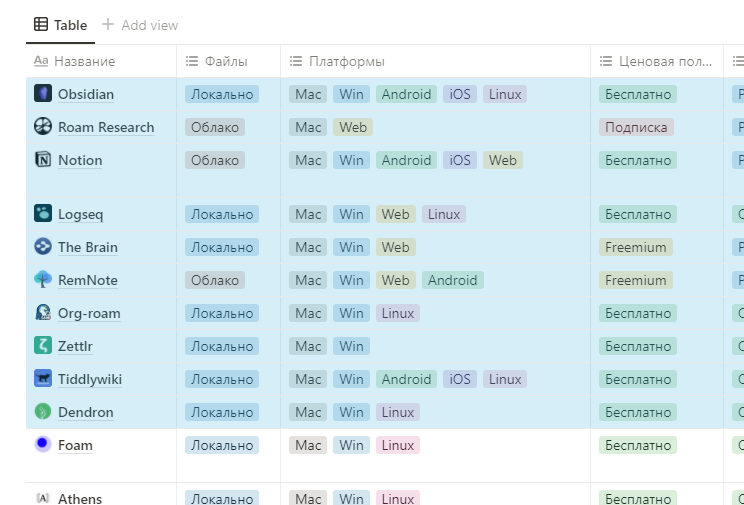
Дайте, пожалуйста, совет мне, как новичку в Zettelkasten, как правильно выбрать из этой таблицы софт для заметок, базы знаний? Что и в какой последовательности читать, изучать, анализировать, пробовать, тестировать? Вариант читать всё подряд как-то меня не вдохновляет. Сейчас пользуюсь OneNote, но чувствую, что не хватает построения взаимосвязей между заметками.
Скажем так, тут дело вкуса. Однако я бы начинал изучение софта по следующему треку:
Обсидина, Ноушн, Логсек, Ремнот, Роам.
А дальше, если ничего из этого не подойдет, то выбирал бы что-то совсем экотическое, воркфлоуи , беар, дендрон. и тд. в целом можно остановится на первых пяти без особых сложностей.
Как бы работал с первыми пятью? Взял бы одна программку, и пару тройку дней погонял бы, может день. Чтобы понять, комфортно или нет. А потом, с той что наиболее комфортно остался бы.
У меня обсидиан, всячески пытаюсь посмотреть в сторону другого софта, но я ретроград и мне сложно изменить привычные шаблоны работы с софтом.
Вы начинаете не с того конца. Согласно первоисточнику, всяко требуется четыре вида заметок: библиографические, повседневные, постоянные и проектные. И форма всех, кроме постоянных, диктуется нам внешними условиями. Как Вы храните библиотеку? Где приходится делать пометки? В какой форме выдаете результаты начальству? Удобство постоянных заметок, т.о. сводится не к красивой картинке на экране, а в удобстве преобразования из одного формата в другой.
Разделяю точку зрения, но часто непонятно зачем это все, пока не попробуешь поработать немного.
У меня изначально была история написать диссертацию, но потом она эволюционировала в то чем занимаюсь. Форум, чатик, клубы, сейчас уже это какие-то курсы.
То есть сбор, анализ и обобщение планомерно переросло в экспрессию и форму самовыражения.
Да, уже говорили, но надо подчеркнуть. Если ящик используется именно как хранилище информации, а не только средства информационного серфинга, то рано или поздно появятся достаточно специфические интроспекционные заметки, описывающие структуру/семантику подмножеств “нормальных” заметок и, даже, заметки-процедуры (методы, демоны). (Этакое самосознание ящика). И тут обычные программы ведения заметок резко начнут мешать, т.к. там обычно нет подобных инструментов, а если и есть, то точно не те, что вам будут нужны. Если вы рассчитываете дорастить свой ящик до такого уровня, то - только чисто текстовое хранилище.
Есть всего три способа: аккуратнее вести карточки проектов, не забывая вносить туда списки попутных идей; отмечать на карточках идей списки использующих их проектов; вести дополнительные карточки для отметки обоих случаев. Самое главное - не забывать помечать просматриваемые карточки при каждом новом поиске. В идеале данная система пометок должна быть полностью подобной той, что у вас в голове. Как вы что-то ищете, по каким признакам? Отразите это в структуре карточек.
Как это поддерживает ваш софт? Тут два варианта: либо он настолько крут и вы настолько хорошо им владеете, что способны написать необходимые программы/шаблоны, облегчающие расстановку и поиск пометок. Либо вы храните все в текстовом виде и значит задача сводится к простому текстовому поиску и правке найденного фрагмента.
Мы тут недавно с @eleeet обсуждали вопрос организации заметок внутри базы, однако так к общему знаменателю и не пришли.
Потому что слишком сложно. Он вообще подтолкнул на мысль касательно того, что база должна быть не только средством сбора, рефлексии и размышлений, но и еще и инструментом обучения. Оно в целом у меня так и получается, однако обучение без структуры, некоего каркаса, получается урывистое. Хочется найти, не серебрянную пулю конечно, но хоть какое-то решение. Можно и с ручной настройкой.
PARA?
У меня после перехода на эту структуру нет проблем с поиском.
При условии распихивания заметок в соответствующие папки, включения в соответствующие moc-и и именования, пригодного для дальнейшего нахождения.
Конечно, у меня заметок сильно меньше вашего, но хотя бы попробовать PARA рекомендую.
Структура папок лучше всего простая - лоток «Входящие»/Inbox и одна основная.
Тут важнее другое - размер заметки, количество мыслей на заметку. Если мыслей много и надо найти не только файл но и абзац в файле — то поиск становится сложным.
Слишком много времени на обслуживание этой системы, я говорил об этом с Тьяго, у него другое мнение. Однако как по мне, проще – лучше. Меньше папок. Но не хватает структуры.
Я не знаю обсудили ли мы этот вопрос или нет, но я отдельно вывод сделал для себя, что возможно, опять же возможно… Инструмент который дает быстрый доступ к инфе и инструмент благодаря которому учишься это не одно и тоже так как задачи и методы разные. Обс отлично подходит для сохранения и обработки инфы. Но обучение это немного другой процесс, за ним стоят другие механики. И то что мы пытаемся натянуть это тема отдельная.
По причине описанной выше я с Геном не согласен. Ибо просто конспектинг в базу это не обучение, это просто конспектинг.
Может быть наша проблема (моя и рустама) в том что мы схлопываем понятия ведения архива и обучения.
Ну это опять же мысли.
А вот тут уже вопрос не к обучению и не к структуре, а к ведению архива и поиска в нем. Если не можешь что-то найти нужно разбираться почему не можешь. У меня с этим проблем пока не было при архиве в 2к заметок. Возможно это еще пока мало и я не уткнулся в эту проблему.
Обучение - это процесс ознакомления и повторения материала, придуманного другими людьми, с целью его запоминания. Другие определения будут диктовать другие решения. Процесс построения можно организовать различным способом. Один из способов - написание конспекта - изложение своими словами услышанных/прочитанных мыслей других людей. Таким образом - написание конспекта (не копирование) - есть процесс обучения, точнее один из необходимых циклов повторения.
Второй момент - изучение материала строится на основе изучения понятий из соответствующей предметной области и в дальнейшем изучения способов оперирования с понятиями. Изучение понятий - тоже удобно организовать в базе знаний как определение новых понятий в отдельных заметках и их последующее уточнение.
Быстрый доступ к информации не является свойством инструмента. Рустам жалуется на сложности с поиском информации. Значит дело не в инструменте.
Если сформулировать еще более конкретно - у формирования собственной базы знаний есть два инструмента, поддерживающих обучение:
пересказ написанного своими словами при формировании записей в базе;
выделение понятий и их взаимодействий в ходе структурного анализа учебного материала.
Основные вопрос которые приходят на ум если будем пытаться обращаться к подходам Скиннера и Кроудера в том что:
чтоб использовать программированное обучение его надо сначала запрограммировать. В нашем же случае мы учимся по ходу формирования материала, фиксированных планов или этапов как таковых нет, контрольных точек тоже нет. Преподавателей для контроля тоже нет.
не понятна механика создания такого подхода на базе Обсидиана, что это должно быть в идеале? какая-то иерархия тегов которую необходимо проходить по шагам? или может наборы папок в которые кладем заметки как этапы обучения? Этот вопрос не понятен.
Может быть есть какой-то простой пример обучения по этому принципу?
В любом случае спасибо за ссылку, поресерчу этот подход подробнее т.к. ранее не натыкался.
Ну, самым замечательным примером подобной обучающей машины является машина Паска. Сам принцип подстройки под ученика.
Маленький огрызок.
При чем тут Zettelkasten? Во-первых, этот участок ящика должен быть структурирован для удобства выбора нужного “модуля”. Во-вторых, ящик должен учиться в процессе. Видимо, поверх постоянной информационной структуры должна быть наложена временная оценочная. Конечно, проще реализовать надстройку отдельной программой со своим хранилищем, но, в принципе, Zettelkasten - это и есть обычная компьютерная база данных, только приспособленная под ручную работу. Так что, наверное, часть результатов обучения может фиксироваться на карточках, а уж итоговые - обязательно.
Ну, так суть программированного обучения в том, что машина не только выдает материал кусками, но и принимает решение о выборе куска и параметрах выдачи (и самое главное - о невозможности выбора - т.е. о выходе ученика за пределы машинных оценок - и передачи управления учителю-человеку). Т.е. нужны “карточки,” где фиксируется текущее состояние системы. Допустим, мы выкладываем на стол карточки-модули. Поверх них кладем цветные фишки - по числу правильных ответов ученика. Время от времени смотрим на эту картину и пытаемся найти в ней какую-то “покерную” комбинацию. Находим и выкладываем на стол соответствующую карточку. С этого момента она тоже влияет на выбор следующего модуля.
Почему быстрый доступ не является свойством инструмента? При запросе к базе мы используем некий запрос который может быть точным и не точным, у нас будет время отклика базы (этим в обсе пренебрегаем), и у нас будет заранее заданный вариант отображения результата. Почему например 3й пп не является свойством?
С этим я согласен. Если мы берем за основу то что обучение это понял и пересказал. Я не могу согласиться что этого достаточно. В каких-то вещах да, но не во всех. Более того на стадии например формирования заметок мы можем что-то законспектить и сохранить локально, плохо связав это с остальными темами, и тут уже вопрос в том как связывать так что было удобоваримо в дальнейшем. Вот это и есть одна из проблем. На которую накладывается проблема отображения результата поиска или исследования связей. Если связи сделать криво, или отображение будет кривое, тогда у нас не сформируется видение как один материал связан с другим.
Может быть потому, что у базы знаний на основе obsidian вообще нет механизма запросов. Нет ни формализованного языка типа select where, ни возможности написать запрос на естественном языке типа ‘что такое искусство?» Кстати, наверное языка запросов ещё в принципе нет нигде, ни в одной из перечисленных выше программ.
Важнейшая задача поиска знаний никак пока не автоматизирована.
Обучение - понял и повторил. Повторить можно движение, действие, дискурсионное рассуждение, последовательность движений, действий, дискурсионных рассуждений. Для обучения надо их повторять. С одного раза запомнить удаётся редко. Значит повторение - за учителем и есть основа, первый шаг обучения. Так и есть - в концепции сюхари -первый шаг, основа - повторение, заучивание за мастером.
Тут вы снова описывает не очень устойчивый к ошибкам и слабый механизм поиска знаний по связям. Хороший механизм позволил бы задать вопрос что такое су-ха-ри и предоставил бы ответ?
Попробую привести ещё один пример.
Поиск по словам — это поиск по знакам. А правильный поиск — по смыслу.
Базе знаний можно задать вопрос «что делает кот или кошка?»
База знаний ответила бы:
Кошка ловит мышей.
Киска купила бы вискас.
Кот любит сметану.
Кот спит на кресле.
И это при том, что в базе знаний нет отдельной заметки по кошкам. Собственно вообще может не быть статей — а только библиотека сочинений Д.Донцовой, например.
Вы написали “база знаний”. Что Вы под этим подразумевали? Конкретную работающую где-то базу знаний? Проект базы? Модель подобной базы? Гипотетическое описание? Чьи-то хотелки?
Слова передают смысл, то насколько четко описаны заметки в базе и даст ответ на вопрос.
Если искать кошку но каждый раз вкидывать запросы типа “котик” “котейка” то логично что мало что найдем. И тут нужна просто некая стандартизация запросов которые отражают смысл.
может и можно в какой-то базе, но я бы в своей искал по ключевым понятиям. например “кошка”, “кошка функции”, “кошка строение” . по сути это как поиск по тегам, но тут присутствует локальная структура записей. например например в заметке кошка, будет ссылка на заметку кошка строение, а в ней будет ссылка на заметку кошка строение урчалка. Фактически имеем что-то типа строктурированных тегов. Это единственный оптимальный пока вариант который я нашел для себя для ответа на подоброго рода вопросы.
Насколько я понял Gudleifr похожая история, только софт по другому сделан и он фиксирует все пути входа в конкретную заметку
Как добиться такого в обсе я пока не придумал
Если заметки нет, то это новая тема. Выдержки из донцовой можно поискать по обычным вхождениям и сделать из них отдельно заметки. Но на практике у меня такого варианта не было ни разу, ну либо это редкий кейс в моем случае. Отдельные упоминания фраз про кошку не помогут мне понять все про кошку. Тут проще к гуглу обратиться, там больше вхождений качественных и там уже инфа полная, хоть и не так структурирована.
У меня так было сначала. До двух сотен заметок было норм, а потом я стал испытывать сложности в нахождении нужного.
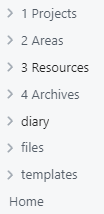
Сейчас у меня из папок PARA + дневник + файлы + шаблоны.
Входящие - это корень хранилища. Может показаться, что это легкомысленный и неряшливый метод, но мне он очень нравится, т.к. правило “пустой инбокс” невозможно не соблюдать: когда новых заметок больше, чем несколько штук - становится некомфортно, и я волей-неволей рассовываю их по соответствующим папкам.
Опять не соглашусь. У меня были поначалу атомарные заметки, и я в них потерялся.
Теперь атомарные заметки - это только “листья” дерева заметок. Остальные - либо MOC, либо увесистые заметки, в которых много букв. Что угодно могу найти довольно легко и быстро.
Заметок не так много, конечно, чтобы делать на основе этого какие-то выводы.
Но главный вывод - для меня сейчас это работает. А мне только этого и надо
Слова передают один из множества смыслов в зависимости от контекста. Контекстов может быть много. Смыслов тоже может быть много. Возникает ситуация многозначности. Например, фраза «мальчик склеил в клубе модель» может иметь совсем разные смыслы.
По сути это и называется поиск знаний не реализован, есть только поиск слов. А вы и я изобретаем костыли.
Другая сложная проблема — найти можно только то, что уже известно, то что заложено в виде «тэгов». А нужно находить ранее неизвестные связи. Например, в соседней теме упомянута связь между сознанием роя и сознанием свободного рынка, из чего можно сделать вывод о наличии связи между роем и рынком. Поиск знаний должен иметь возможность предложить такую связь человеку.
Я пока это не реализовал у себя и мотивирую себя на решение такой задачи.
Может быть, у меня восторг неофита либо другое когнитивное искажение, но вот вообще не могу припомнить, чтобы я тратил сколько-нибудь заметное время на обслуживание этой системы.
Единственное, на что потребовалось время - это на рефакторинг хранилища из формата LYT в PARA. Да и то - кажется, на удаление артефактов LYT ушло больше времени, чем на создание артефактов PARA
В ходе использования хранилища время нужно только на то, чтобы переместить новую заметку в нужную папку. Этот навык быстро доходит до автоматизма и занимает незначительную долю времени от общего времени оформления новой заметки.
Практика - критерий истины. Предлагаю попробовать. Хотя бы на новых заметках (чтобы не тратить время на рефакторинг всего хранилища, пока нет уверенности, что это стоит того )
Да согласен, но повторюсь это зависит от того какие термины и как мы используем. Если мы определяем что-то очевидным ярлыком то и проблем с этим в дальнейшем быть не должно. Ну по крайней мере у меня не было такого чтоб я искал путан а нашел кружок моделирования.
А прям нужно находить? Я много слышал от разных людей что они гоняются за этой синергией, в том числе и сам Зонке. Но пока еще не встретил примера хорошей реализации где это продвинуло человека в чем-то вперед. Я тут как человек очень тупенький сразу хочу практической пользы от такой штуки. У вас есть примеры такой полезной синергии которая потом во что-то переросла? Возможно я просто не вижу и не понимаю в чем польза.
Сделанных мной вручную и более-менее прилично оформленных - около 500.
В общей сложности, включая справочный контент полностью внешнего происхождения - ~1500.
Ну, как бы, полагается, что проторение связей между возбужденными [квази]нейронными ансамблями и является основным механизмов долговременного запоминания. А также любого моделирования.
Ну я согласен, в моем видении синергия не проявляется когда я нашел две разные по интенту заметки. Я либо думаю о чем-то конкретном, либо сознательно некоторые аспекты перебираю “а что есть в связи с вот этой область”.
А так чтоб прямо само собой две заметки состыковались и дали мне инсайд на подумать… такого кейса у меня не было, поэтому и попросил пример.
Обычно у меня получается то что я думаю а не из набора случайных совпадений слов в заметках. Возможно это связано с тем что база так организована.
В настоящий момент перевод между языками реализован подобным образом, например. Детали, разумеется, скрыты. Есть свои недостатки - но в целом очень хорошо.
Перевод обычно делается на мощных внешних серверах. Мне же интересно - что именно будет возможно реализовать на ноутбуке без специализированного GPU. Как это будет работать.
 Может аутлайном попробовать, думаю? Ссылки на темы ещё нужны будут.



 )